 2026-09-26 19:20
Vue3 博客 CSR 改 SSR 全记录:为了让百度收录,我把前台重写了一遍
先交代下背景,不然后面的坑看着没头没尾。
这个博客上线快两年了,前阵子刚把整个博客重新重构了一遍。前台 Vue3 + Vite + Element Plus,状态管理用 Pinia;后端 Node + Express,Prisma 管数据库;前后端分离,接口对接口,各管各的。后台管理也是 Vue 写的单页应用,跟前台共用一套后端。当时选这套没什么深思熟虑,就是熟,写起来快,页面交互也舒服。
博客这东西,写着写着就有感情了。文章攒到现在几十篇,JWT 认证、评论、相册、许愿墙、暗黑模式,功能越加越多,自己用着挺爽。但个人博客有个绕不开的宿命——没人看。朋友圈不好意思天天发,搜索流量又一直是零,我就琢磨问题出在哪。
用到现在,功能上没什么不满。直到前阵子心血来潮,搜了下 site:www.sanshijiu.cn。
好家伙,百度就收录了一个首页,还是刚建站那会儿抓的。
先搞懂几个词,不然容易懵
讲方案之前,先把几个行话说清楚,这也是我当时临时补课的内容。已经懂的朋友可以直接跳过。
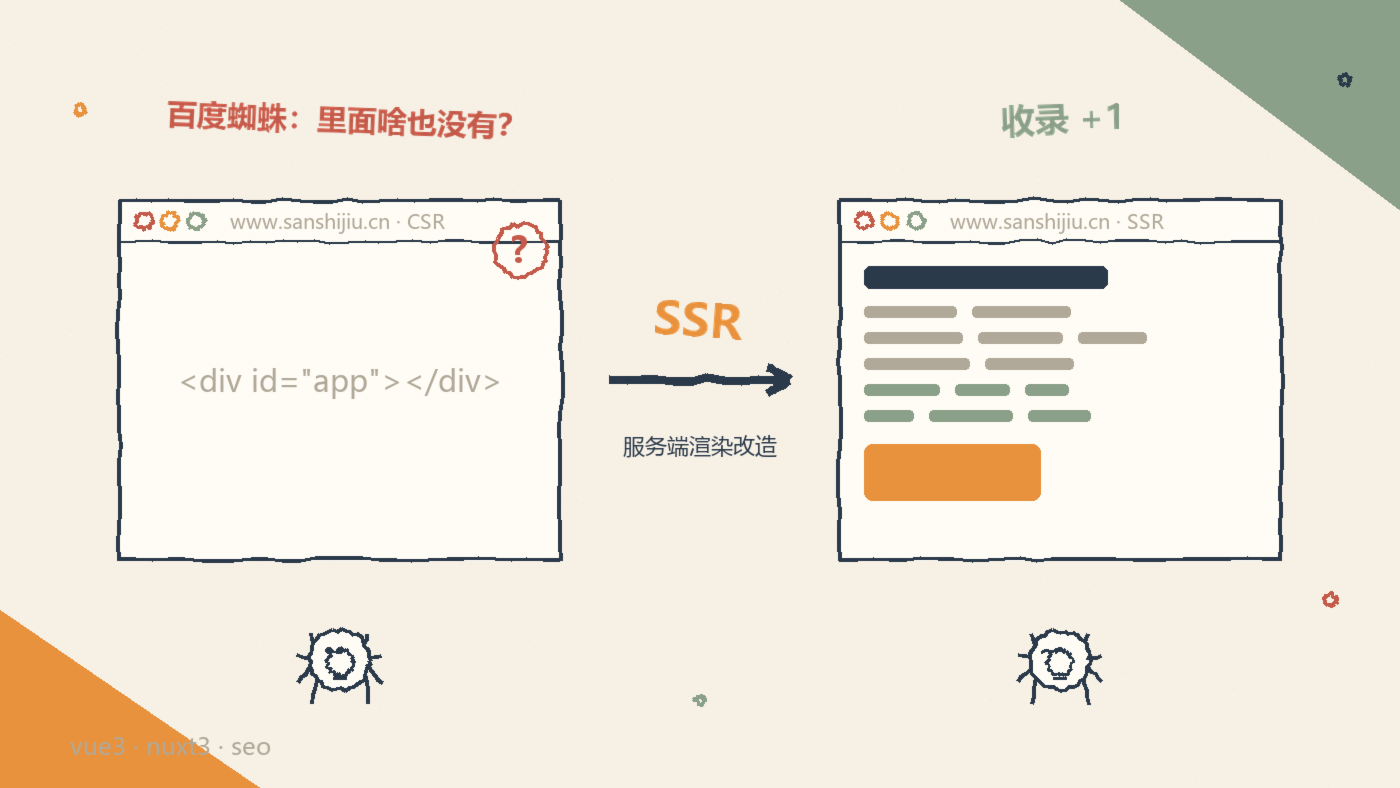
蜘蛛(爬虫/Spider):搜索引擎派来的"小程序",定时访问你的网页、把内容抓回去建索引。你的站能不能被搜到,第一道关就是蜘蛛来了能不能看懂页面。
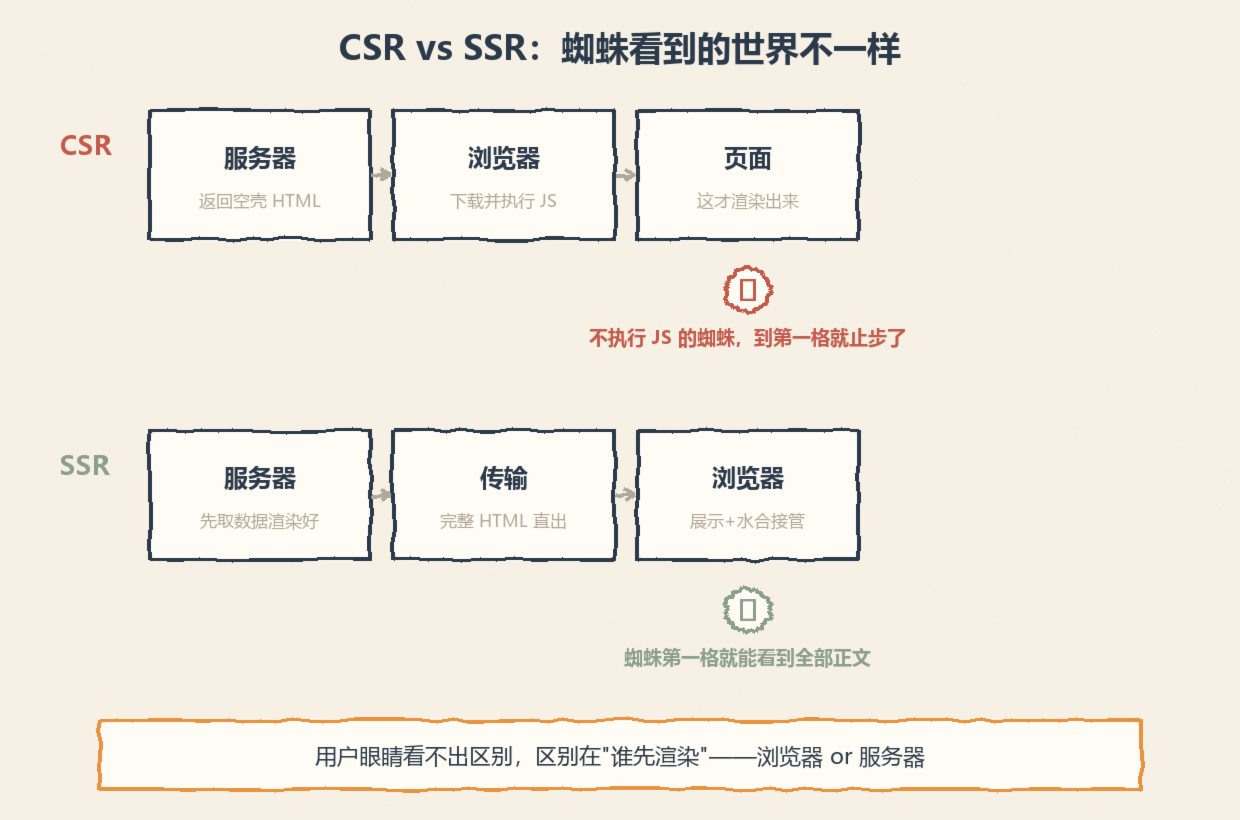
CSR(客户端渲染):Vue、React 这类前后端分离的默认玩法。服务器返回的 HTML 是个空壳,正文全靠浏览器下载 JS、执行 JS 之后现场生成。
SSR(服务端渲染):请求到了服务器,服务器先把数据取好、把 HTML 拼完整,再吐给浏览器。蜘蛛拿到手的就是一篇能直接读的文章。
水合(Hydration):SSR 输出的 HTML 一开始只是"看得见但点不动"的静态页面,等浏览器把 JS 加载完,Vue 再把事件、响应式状态"接"到现有 DOM 上,页面才真正活过来。这个接管过程就叫水合。
为什么 Google 没事、百度有事?因为 Google 的蜘蛛会执行 JS,相当于它自带一个浏览器;而百度蜘蛛长期不执行 JS(或者说执行得很弱),它每天来,看到的都是那个空壳。空口无凭,curl 拉了下自己首页的源码:
<body><div id="app"></div></body>
一个 div,没了。这就是百度蜘蛛眼里的这个站。写了两年的几十篇文章,在它那儿等于不存在,挺扎心的。
路怎么选
查了下方案,无非几种。
预渲染(SSG):构建时把页面生成静态 HTML。听着美好,但我的文章是动态的,归档、列表这些页面数据天天变,没法在构建时写死,pass。
SSR:请求过来,服务器先把完整 HTML 渲染好再返回,蜘蛛一来就能看到全部内容。正路,但前端要从 Vue 单页应用换成 Nuxt,基本等于重写一遍。
给百度单独做一套静态页:有些老站真这么干,维护两套页面,想想都恶心,pass。
纠结了两天还是走 SSR。不过没按官方那套部署来(那套要服务器跑构建,2G 内存的小机器遭不住,npm run build 能把内存吃满直接 OOM),改成:本地构建好产物,打包传上去,服务器只负责跑 Node。后台管理不迁,后台又不需要 SEO,老代码继续用。
下面是全过程,技术栈跟我差不多的(Vue3 + Vite + Node 后端),理论上可以照着走。每一步我都会说清楚"为什么",因为当初我自己抄教程时,最烦的就是只给代码不讲原因。
第一步:搬家,不是重写
新建一个 Nuxt3 项目,然后把老项目的东西往里搬。听起来吓人,实际工作量比想象小,因为 Nuxt3 底层就是 Vue3,组件基本原样复制,<script setup> 写法、Pinia、Element Plus 全都还能用。
搬的东西:components/ 整个目录、pages/ 下的 vue 文件(原来 vue-router 的路由文件删掉,Nuxt 按文件名自动生成路由,post/[id].vue 就是 /post/:id)、全局样式挪到 assets/ 再在 nuxt.config 里引。
新手提示:Nuxt 的约定路由省掉了路由配置文件,但代价是文件名即路由,动态参数用方括号,404 页面就叫 [...slug].vue。搬的时候建议先搬一个最简单的页面跑通,再批量复制,别一口气全塞进去然后对着满屏报错发呆。
真正要动脑子的是接口层。老项目用的 axios,全站到处 import request from '@/api/request'。要是把几十个接口调用全改成 Nuxt 的写法,改到天荒地老。我的做法是在 composables 里封一个假的"request",把 axios 那套方法名模拟出来,api/ 目录一行没动就跑起来了。
// composables/useApi.js,核心思路
export const $api = $fetch.create({
  // 服务端直连后端,浏览器端走相对路径
  baseURL: import.meta.server ? 'http://127.0.0.1:3000' : '',
  onRequest({ options }) {
    const account = useAccountStore()
    if (account.token) {
      options.headers = new Headers(options.headers)
      options.headers.set('Authorization', `Bearer ${account.token}`)
    }
  },
  onResponse({ response }) {
    // 统一拆后端的 { code, data, message } 包装
    const body = response._data
    if (body && body.code !== 200) throw createError({ message: body.message })
    response._data = body.data
  },
})

export function useApiData(key, url, options = {}) {
  return useFetch(url, { key, ...options, $fetch: $api })
}
注意那个 baseURL 的写法,服务端直连 127.0.0.1:3000。一开始我偷懒让服务端也走相对路径让内部代理转发,结果在服务器上 502,折腾半天不如直连来得干脆。原因也简单:浏览器里的相对路径是相对当前域名的,有 Nginx 帮你转;但 Node 服务端发请求时没有"当前域名"这个概念,相对路径直接就废了。
第二步:状态挪进 cookie
Pinia 的 store 在 CSR 里靠 localStorage 持久化,但服务端渲染时读不到 localStorage——服务端跑在 Node 里,哪来的 localStorage。直接读只会拿到 undefined,然后首屏渲染出一个"未登录"状态,水合时浏览器又说"已登录",两边打架,控制台一片水合警告。
所以凡是服务端渲染时就要用的状态,都得换成 cookie。我搬了两个:登录 token、暗黑模式主题。Nuxt 有现成的 useCookie,跟 ref 一个用法:
const token = useCookie('token', { maxAge: 60 * 60 * 24 * 30 })
服务端和浏览器端都读得到,水合的时候也不会对不上。
纯客户端的状态(比如音乐播放器进度这种)不用管,留在 localStorage 里没事。判断标准就一句话:这个状态会不会影响首屏 HTML?会影响,就进 cookie;只在用户点了之后才用,留着别动。
第三步:首页和文章页数据直出
这是整个改造的灵魂。以前页面的数据是 mounted 之后请求接口再填进去的,现在要让服务端把数据取好、连着 HTML 一起发出去。
用上面封的 useApiData,写起来跟以前的 useFetch 没啥区别:
// pages/post/[id].vue
const route = useRoute()
const { data: post } = await useApiData(`post-${route.params.id}`, `/api/post/${route.params.id}`)
就多了个 await。Nuxt 会在服务端执行到这里,等接口返回,把数据填进 HTML 再发给浏览器。数据还会被序列化进页面,浏览器端接管的时候不用重新请求一遍——用户感觉打开速度反而变快了,因为省掉了"白屏等 JS → 请求接口 → 渲染"这一长串。
我把首页、文章页、归档页这三个最需要 SEO 的页面做成了直出,别的页面(相册、留言板这种)保持客户端请求,省事,也没那个必要。别追求全站 SSR,挑蜘蛛真正关心的页面做就行,多做一个就多一份服务端开销和调试成本。
第四步:暗黑模式防闪
老站切暗黑模式是 JS 在浏览器里给 html 加 class,SSR 之后有个尴尬:服务端渲染时不知道用户选的什么主题,首屏按亮色输出,浏览器一接管发现用户是暗色,白屏闪一下再变黑,很掉价。深夜刷博客的人被白光糊一脸,体验灾难。
解法就是第二步埋的伏笔——主题存 cookie,服务端直接读:
const theme = useCookie('theme')
useHead({
  htmlAttrs: { class: () => theme.value === 'dark' ? 'dark' : '' },
})
服务端输出的 HTML 带着 dark class,首屏就是暗的,一点不闪。

顺便理解一下水合:上面图里那个"服务端画骨架、浏览器装神经"的过程,首屏内容是服务端给的,交互是水合之后才有的。凡是依赖"随机数""当前时间""本地存储"的逻辑,服务端和浏览器算出来不一样,水合必报警,这类代码统一挪到 onMounted 之后再跑。
第五步:构建、打包、部署
本地构建:
npm run build
产物在 .output/ 目录,server 端 + 静态资源都在里面。这里有两个 Windows 特有的坑,都是我拿一晚上换来的。
一是 Nuxt 在 Windows 上构建,.output/server/node_modules 里用的是 junction 链接(类似软链接),打包压缩再传到 Linux,链接全断,起不来就报 Cannot find package 'hookable'。所以打包时把这个目录排除掉:
tar --exclude='.output/server/node_modules' -czf nuxt-output.tar.gz .output
传到服务器解压,再进 .output/server 里 npm install --omit=dev 装真依赖。
二是 Node 版本。我服务器是 Node 17.9.1,而全局 fetch 是 Node 18 才内置的。症状很迷惑:页面能打开,数据全空,日志里接口请求全失败,本地却完全正常。我盯着这个"本地好好的、线上全空"的问题怀疑人生了一个多小时,最后才想起来两边 Node 版本不一样。解决方法就一行:
node --experimental-fetch index.mjs
启动命令带上这个参数。加日志重定向放后台:
nohup node --experimental-fetch index.mjs > app.log 2>&1 &
给后来者的建议:服务器该升 Node 就升,17 早就 EOL 了,我是嫌动环境麻烦才打补丁,能升别学我。 另外 Nuxt 产物默认监听 3000,跟我的后端 API 撞了,写了个构建后的小脚本把默认端口改成 3001,不然起不来。
第六步:Nginx 分流
最后一步,把流量分对地方。一个域名进来,三类请求要去三个地方:接口和上传文件给老后端,前台页面给 Nuxt,后台和静态资源走老 dist。

我的配置核心就这几段:
# 接口和上传的静态文件,走老后端 3000
location /api    { proxy_pass http://127.0.0.1:3000; }
location /static { proxy_pass http://127.0.0.1:3000; }

# 前台 SSR,其余所有路径
location / { proxy_pass http://127.0.0.1:3001; }

# 前端构建产物带 hash,放心缓存
location ^~ /_nuxt/ {
    proxy_pass http://127.0.0.1:3001;
    expires 30d;
}

# 后台管理还是老静态文件,history 路由刷新要能兜回 index.html
location ^~ /admin {
    root /www/wwwroot/www.sanshijiu.cn/dist;
    try_files $uri $uri/ /index.html;
}
location = /index.html {
    root /www/wwwroot/www.sanshijiu.cn/dist;
}
单独说下 location = /index.html 这段,这个坑卡了我挺久。后台是老的 SPA,刷新 /admin/xxx 时 Nginx 会 try_files 兜回 /index.html,但这个内部重定向会重新走一遍 location 匹配,被上面 location / 的反代规则截胡,转给 Nuxt 去渲染,Nuxt 里没这个路由,404。给 /index.html 单独配一段精确匹配(= 是精确匹配,优先级最高),指回静态目录,才消停。
改完 Nginx 记得 nginx -t 测一遍配置再 nginx -s reload,别直接 reload,语法错了线上瞬间 502,别问我怎么知道的。
其他的坑
捡印象深的补几个。
popper 报 'placements' not found。Element Plus 依赖的 @popperjs/core 是 CJS 包,具名导出在 Node 17 下解析不好,SSR 阶段直接炸。nuxt.config 里加一行让它内联:
vite: { ssr: { noExternal: ['@popperjs/core'] } }
水合警告刷屏。我有个随机切换背景图的逻辑,服务端随机了一个,浏览器端又随机一个,两边对不上。凡是"随机""当前时间"这类每次执行结果不同的代码,都得挪到客户端挂载之后跑,服务端别掺和。排查水合警告有个笨办法:看警告里的 DOM 差异节点,顺着那个组件往上找,十有八九能定位到。
sitemap.xml 和 robots.txt。让后端直接吐这两个文件,文章列表查一遍库拼 XML,加密的文章不往里放。robots 把后台、个人中心、接口路径都 Disallow 掉。然后去站长平台提交 sitemap,剩下的交给时间。
页面 meta 别忘配。SSR 只是让蜘蛛能读到内容,但标题、描述这些"简历"得自己写。用 Nuxt 的 useSeoMeta 给每个页面配 title、description、og 标签,文章页的标题直接用文章标题:
useSeoMeta({
  title: () => post.value?.title,
  description: () => post.value?.summary || post.value?.content?.slice(0, 100),
  ogTitle: () => post.value?.title,
  ogType: 'article',
})
怎么确认成了
别看页面显示正常——CSR 时代页面也显示正常。唯一的检验标准是源码:
curl -s https://你的域名 | grep 某篇文章的标题
能 grep 出来,说明内容真的在 HTML 里,蜘蛛看得到。我改完源码从 1KB 变成 170 多 K,标题正文全躺在里面,成了。那一刻挺爽的,折腾几天就等这一行输出。
再补两个验证手段:浏览器右键"查看网页源代码"(不是 F12 的 Elements,那个是 JS 跑完后的结果,CSR 也能看到内容,不算数);以及百度搜索资源平台的"抓取诊断",直接看百度蜘蛛抓到的原文,最权威。
复盘:花了多久,值不值
实际搬了大概三个晚上加一个周末。第一晚搭架子搬组件,第二晚死磕接口层和水合警告,部署那晚基本全耗在 Windows 打包链接和 Node 版本上——真正写业务代码的时间,反而不到三分之一。这也是我想分享的一点:SSR 改造的难点从来不是新语法,而是"同一套代码要在两个环境里跑"带来的环境差异。
值不值?对个人博客来说,投入产出比其实见仁见智。但我觉得值,理由有三个:首屏确实快了,弱网和老设备感受明显;逼着自己把项目从"能跑就行"收拾到了"结构清晰";以后写技术文章,至少有机会被需要的人搜到,而不是烂在自己的服务器里。
如果你也打算动手,按这个清单过一遍,能避开我踩的大部分坑:
- 先搬一个最简单的页面跑通,再批量复制
- 服务端请求必须用完整地址,别写相对路径
- 影响首屏的状态进 cookie,其余留 localStorage
- 只给首页、详情页、列表页做直出,别贪多
- 随机/时间相关逻辑全部挪到 onMounted 之后
- Windows 打包排除
.output/server/node_modules - 服务器 Node 升到 18+,一劳永逸
- Nginx 改完先
nginx -t - sitemap、robots、每页 meta 配齐,再去站长平台提交
- 最后用 curl grep 标题验收,别信眼睛
百度什么时候收录不知道,反正这次不是它的问题了。收录了回来更新一句。
如果你也是 Vue3 前后端分离的站,被收录问题折磨,上面这些步骤基本可以照抄。有拿不准的地方,评论区聊。